ElevenLabs auf Deutsch: Erfahrungen mit Aussprache und Wortzeiten
Wir haben unseren Erklärfilm mit einer deutschen KI-Stimme von ElevenLabs vertont, in zwei Fassungen. Was gut lief, welche Wörter die Stimme falsch las, wie wir es gelöst haben und was die Zahlen aus dem Protokoll zeigen.
KI-Stimmen klingen in Demos beeindruckend. Ob sie im eigenen Projekt halten, zeigt sich an den Wörtern, die in keiner Demo vorkommen: Abkürzungen, Fachbegriffe, Firmennamen.
Was wir vertont haben
Dieser Bericht beruht auf einem echten Projekt, nicht auf einem Labortest: dem Erklärfilm «So arbeiten wir» für unsere Startseite, 81 Sekunden, 13 Sprechzeilen, 129 Wörter. Wie der Film selbst entstanden ist, beschreiben wir im Artikel Erklärvideo selber machen. Hier geht es nur um die Stimme. Alle Zahlen stammen aus den Projektdateien: dem Sprecherplan, den gespeicherten Antworten der Schnittstelle und dem Protokoll jeder Anfrage.
Verwendet haben wir eine deutschsprachig nutzbare Stimme aus der Bibliothek von ElevenLabs («Michael») mit dem mehrsprachigen Modell, leicht beschleunigt (Einstellung 1.08) und mit einer Stabilität von 0.55. Jede Sprechzeile wurde einzeln erzeugt, mit dem vorherigen und dem nächsten Satz als Kontext, damit die Betonung über die Zeilen hinweg zusammenpasst, und mit einem festen Startwert, damit eine erneute Erzeugung gleich klingt. Eine Übersicht über ElevenLabs und andere Sprach-Werkzeuge findest du in Die besten Voice-AI-Tools 2026; dieser Artikel ist der Erfahrungsbericht zu einem davon.
- Sprechzeilen
- 13
- gesprochene Wörter
- 129
- Wörter pro Sekunde
- 1,85
- ≈ 111 pro Minute
- Antwortzeit je Zeile
- 0,5–1,9 s
- einmal 19,8 s
Was ohne Nachhilfe gut klang
Die meisten Sätze haben wir genau so vertont, wie sie im Untertitel stehen. «Eine neue Anfrage. Direkt über Ihre Website.» «Teure Software-Lizenzen? Wir bauen Ihre eigene Web-AppEine Web-App ist eine Anwendung, die im Browser läuft und sich wie ein Programm bedienen lässt — mit Login, Eingaben, gespeicherten Daten und Abläufen. Anders…Mehr erfahren →, genau so, wie Sie arbeiten.» Das klang natürlich, mit passenden Pausen an Punkt und Komma, und die Frage am Satzende wurde als Frage gesprochen.
Auch Marken- und Firmennamen machten weniger Ärger als erwartet: Google AdsGoogle Ads ist die Werbeplattform von Google. Unternehmen schalten damit Anzeigen in der Google-Suche, auf YouTube, im Display-Netzwerk, in Gmail und in Google…Mehr erfahren →, ShopifyShopify ist eine gehostete E-Commerce-Plattform, mit der Unternehmen einen Onlineshop betreiben, ohne eigene Server oder Shop-Software zu warten. Produkte,…Mehr erfahren →, Han Kitchen, Karo Kanaltechnik, Bodin Bau, The Sartorialist. Nur einen Firmennamen haben wir in der Schreibweise angepasst, weil die Grossbuchstaben ihn sonst buchstabiert hätten: Für JUCAN bekam die Stimme «Jucan», im Untertitel steht weiterhin JUCAN.
Zahlen haben wir ausgeschrieben. Im Untertitel stehen Ziffern, die Stimme bekommt das ausgeschriebene Wort, bei einer Prozentangabe samt «Prozent». Das übernimmt inzwischen ein Skript.
Die Aussprache-Falle: Abkürzungen
In der ersten Fassung vom 29. Oktober 2026 hatten wir Abkürzungen von Hand buchstabiert, um sicherzugehen: «S-E-O», «G-E-O», «K-I», «Chat-G-P-T», «D-L-M». Das Ergebnis klang englisch und abgehackt, gerade bei SEOSEO (Search Engine Optimization, Suchmaschinenoptimierung) umfasst alle Massnahmen, mit denen eine Website in den unbezahlten Suchergebnissen von Google und…Mehr erfahren → und KI, die im Schweizer Alltag deutsch ausgesprochen werden. Bei ChatGPT war es umgekehrt: Das sagt kaum jemand deutsch buchstabiert.
Am 5. November gab es deshalb eine Hörprobe: mehrere Schreibvarianten derselben Abkürzung im selben kurzen Satz, mit derselben Stimme und denselben Einstellungen, angehört und per Auswahl entschieden.
| Untertitel | Fassung 1 (29.10.) | Fassung 2 (5.11.) | Klingt wie |
|---|---|---|---|
| SEO | S-E-O | Es-E-O | deutsch buchstabiert |
| GEO | G-E-O | Ge-E-O | deutsch buchstabiert |
| KI | K-I | Ka-I | deutsch |
| ChatGPT | Chat-G-P-T | Tschätt-Dschi-Pi-Ti | englisch, wie im Alltag |
| DLM | D-L-M | Di-El-Em | englisch (Entscheid Auftraggeber) |
Der Trick dabei: Jede gesprochene Form ist ein einziges Wort mit Bindestrichen. So haben Untertitel und Sprechertext immer gleich viele Wörter, und die Wortzeiten der Stimme passen eins zu eins auf die Wörter im Untertitel. Würde «SEO» zu drei Wörtern, liefen Untertitel und Bild auseinander.
Seit diesem Tag gilt bei uns eine Regel: Der Sprechertext wird nie mehr von Hand geschrieben. Ein Skript leitet ihn aus dem Untertitel ab und schlägt jedes Wort in einem Aussprache-Lexikon nach. Im Lexikon stehen nur Wörter, die die Stimme nachweislich falsch liest, jedes mit dem Datum der Hörprobe. Einträge für weitere Abkürzungen wie KMU, CRMEin CRM (Customer Relationship Management) ist eine Software, in der ein Unternehmen alle Informationen zu Kunden und Interessenten zentral verwaltet:…Mehr erfahren → oder MVPEin Minimum Viable Product (MVP) ist die kleinste lauffähige Version eines Produkts, die für echte Nutzer bereits einen vollständigen Nutzen erfüllt und…Mehr erfahren → sind als Vorschläge markiert und werden erst nach einer eigenen Hörprobe benutzt. Wörter, die ohne Eintrag richtig klingen, bleiben draussen. Jede Korrektur, die nicht nötig ist, macht den Klang eher schlechter.
Wie lange die Hörprobe dauerte? Weniger als eine Viertelstunde für fünf Abkürzungen. Gespart hat sie eine dritte Fassung des Films. Wer eine KI-Stimme für Kundenvideos einsetzt, sollte diese Viertelstunde am Anfang jedes Projekts einplanen, bevor der erste Satz vertont wird, nicht erst, wenn jemand den fertigen Film anhört und stutzt.
Wortzeiten: der unterschätzte Teil
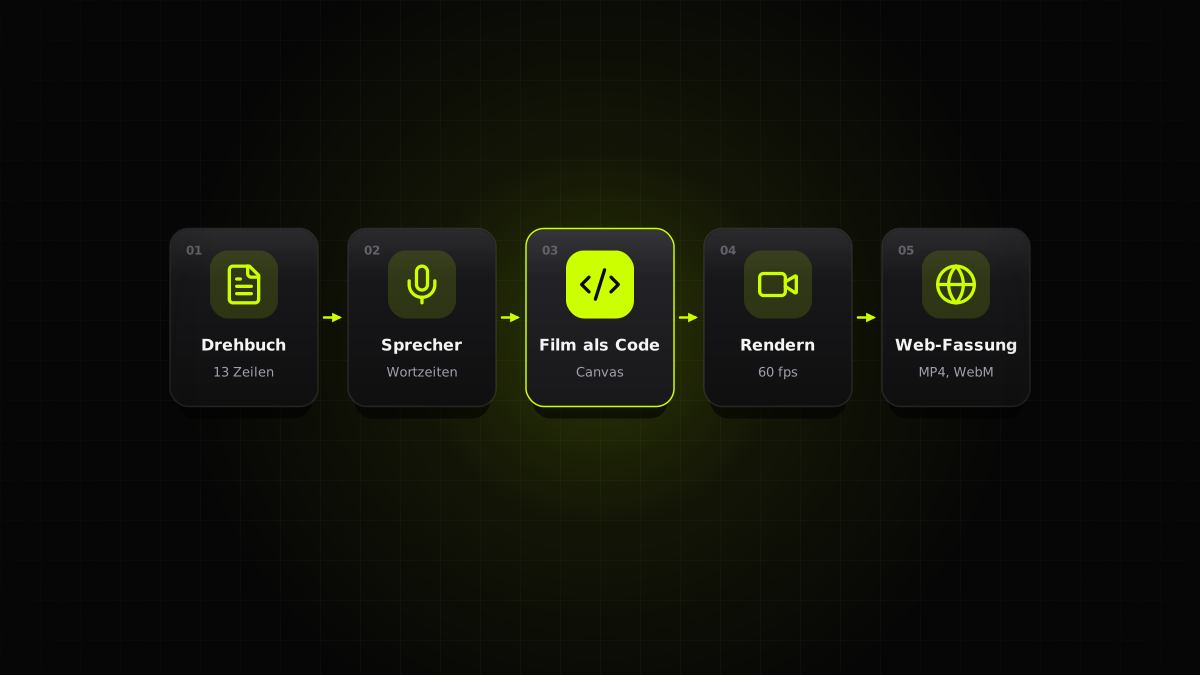
Für ein Video ist nicht nur wichtig, wie die Stimme klingt, sondern wann sie was sagt. ElevenLabs bietet dafür eine Variante der Sprachausgabe mit Zeitangaben: Zu jedem Zeichen kommen Start und Ende in Sekunden zurück. Unser Skript fasst die Zeichen zu Wörtern zusammen, schneidet jede Zeile exakt auf das erste und letzte Zeichen zu und legt sie mit einer festen Pause hintereinander.
Daraus entstehen zwei Dinge. Erstens die Untertitel: Die Untertiteldatei des Films ist direkt aus diesen Zeiten erzeugt, ohne Handarbeit. Zweitens die Bildwechsel: Jede Szene beginnt bei einem bestimmten Wort. Als in Fassung 2 aus «Chat-G-P-T» das Wort «Tschätt-Dschi-Pi-Ti» wurde, mussten wir nur den Anker im Film von einem Wort auf das andere umstellen.
Interessant ist das Sprechtempo, das sich aus den Zeiten ablesen lässt. Im Schnitt spricht die Stimme 1,85 Wörter pro Sekunde, also rund 111 pro Minute. Die schnellste Zeile liegt bei 2,39, die Endkarte mit Firmenname und Aufforderung bei 1,27. Das ist ruhig genug, dass man auch ohne Ton im Untertitel mitkommt. Unsere Regel war, bei Zeitnot den Satz zu kürzen, nie die Stimme schneller zu stellen. Eine beschleunigte Stimme klingt gehetzt, ein kürzerer Satz klingt bestimmt.
Sprechtempo je Zeile (Auswahl)
Die Gegenprobe
Was die Stimme tatsächlich gesagt hat, prüft man am besten nicht nur mit den Ohren. Unser Ablauf sieht nach jeder Vertonung eine Gegenprobe vor: Die fertige Tonspur geht durch eine Spracherkennung, und ein Skript vergleicht das Erkannte Wort für Wort mit dem Untertitel. Fehlt ein Wort oder steht ein anderes da, wird die Zeile angehört und gegebenenfalls neu erzeugt.
Dabei gilt es, die Spracherkennung richtig zu lesen. Sie schreibt Zahlen und Eigennamen oft anders, als sie im Untertitel stehen, etwa einen Firmennamen phonetisch. Das ist kein Fehler, solange es richtig klingt. Ein fehlendes Wort dagegen ist einer. Ein schriftliches Protokoll dieser Gegenprobe für den Film liegt in unseren Projektdateien nicht vor; wir beschreiben hier das Verfahren, nicht ein Messergebnis.
Unser Ablauf für jede Vertonung
KI-Sprecher auf Deutsch: unser Ablauf
Untertitel schreiben
Was im Bild steht, in normaler Schreibweise: «SEO», Ziffern, Schweizer «ss». Kurze Sätze, höchstens etwa 15 Wörter.
Sprechertext ableiten und prüfen
Das Skript ersetzt Abkürzungen aus dem Lexikon, schreibt Zahlen aus und prüft, dass beide Fassungen gleich viele Wörter haben. Bei unbekannten Abkürzungen stoppt es.
Hörprobe bei neuen Wörtern
Zwei bis vier Varianten im selben Satz erzeugen, anhören, entscheiden. Die gewählte Form mit Datum ins Lexikon.
Vertonen mit Wortzeiten
Jede Zeile einzeln, mit Nachbarsätzen als Kontext und festem Startwert. Antworten werden gespeichert, damit eine erneute Erzeugung nichts kostet, solange sich der Text nicht ändert.
Gegenprobe
Spracherkennung über die Tonspur, Vergleich mit dem Untertitel, Abweichungen anhören.
Ein Detail aus dem Protokoll: Am 29. Oktober gingen 26 Anfragen an die Schnittstelle, zwei vollständige Durchgänge mit je 13 Zeilen. Am 5. November waren es 13, weil der Text jeder Zeile sich geändert hatte. Hätte sich nur eine Zeile geändert, wäre nur eine neu erzeugt worden. Die Antwortzeit lag bei fast allen Zeilen unter zwei Sekunden, nur die allererste Anfrage brauchte knapp 20.
Was wir nicht getestet haben
Wir haben eine einzige Stimme in einem einzigen Projekt eingesetzt. Wie andere Stimmen mit denselben Wörtern umgehen, wissen wir nicht. Schweizerdeutsch haben wir nicht versucht; unser Film ist Hochdeutsch mit Schweizer Schreibweise. Ebenso wenig haben wir Stimmen geklont oder die Telefon- und Agenten-Funktionen des Anbieters ausprobiert. Und wir nennen hier keine Preise: Die Abrechnung hängt vom Abo ab und ändert sich; aktuelle Angaben stehen auf der Preisseite des Herstellers.
Für wen sich eine KI-Stimme lohnt
Eine KI-Stimme lohnt sich, wenn Videos oft angepasst werden, wenn mehrere Fassungen nötig sind oder wenn kein Budget für eine Sprecherin im Studio da ist. Sie lohnt sich weniger für einen einmaligen Imagefilm, bei dem die Stimme den Charakter der Marke tragen soll. Dort ist ein Mensch oft die bessere Wahl.
Wenn du Videos mit KI-Stimme als Teil deiner Inhalte planst, gehört das zu unserer Arbeit als Content-Marketing-Agentur. Wenn du wissen willst, wo KI-Stimmen in deinem Betrieb sinnvoll sind, etwa für Erklärvideos, Schulungen oder Telefonansagen, hilft eine KI-Beratung. Und für eigene Abläufe mit Sprachausgabe, etwa automatisch vertonte Anleitungen, ist die KI-gestützte Entwicklung der Ausgangspunkt.
Quellen
Fazit
ElevenLabs hat in unserem Projekt das geliefert, was ein Erklärfilm braucht: eine natürliche Stimme für normale Sätze und genaue Zeiten für jedes Zeichen. Die Schwachstelle sind Abkürzungen, und die lässt sich nicht am Schreibtisch lösen, sondern nur mit einer Hörprobe. Seit wir die Aussprache in einem Lexikon festhalten und den Sprechertext automatisch ableiten, ist die Stimme vom Risiko zum zuverlässigsten Teil der Produktion geworden.
Häufige Fragen
Wie gut spricht ElevenLabs Deutsch?+
In unserem Erklärfilm klangen normale deutsche Sätze, Firmennamen und Produktnamen wie Shopify oder Google Ads ohne Nachhilfe natürlich. Probleme machten Abkürzungen: Von Hand buchstabiert («S-E-O», «Chat-G-P-T») klangen sie englisch und abgehackt. Erst nach einer Hörprobe mit mehreren Schreibvarianten stimmte die Aussprache.
Wie bringt man ElevenLabs bei, Abkürzungen richtig auszusprechen?+
Indem man der Stimme nicht die Abkürzung gibt, sondern die gesprochene Form als ein Wort mit Bindestrichen, etwa «Es-E-O» für SEO. Welche Form richtig klingt, entscheidet eine Hörprobe mit zwei bis vier Varianten. Die gewählte Form kommt in ein Aussprache-Lexikon, und der Sprechertext wird daraus automatisch erzeugt.
Kann ElevenLabs Untertitel mit genauen Zeiten liefern?+
Die Schnittstelle «with-timestamps» liefert zu jedem Zeichen Start- und Endzeit. Daraus haben wir Wortzeiten gebildet und die Untertitel und alle Bildwechsel unseres Films darauf ausgerichtet. Das funktionierte ohne Nacharbeit.
Ist eine KI-Stimme rechtlich unproblematisch für Werbung?+
Für eine Stimme aus der Bibliothek des Anbieters gelten dessen Nutzungsbedingungen und das gewählte Abo, die man vor dem kommerziellen Einsatz lesen sollte. Eine geklonte Stimme einer realen Person braucht deren ausdrückliche Einwilligung. Wir haben eine Bibliotheksstimme verwendet.
Über den Autor
Daniel MüllerSenior Developer & SEO-Stratege
Daniel Müller ist Senior Developer und SEO-Stratege bei DLM Digital in Zürich. Mit über 10 Jahren Erfahrung in Webentwicklung, SEO, GEO/AEO und KI-Integration begleitet er Schweizer KMU bei der digitalen Transformation. Im DLM Magazin schreibt er über KI, Vibe Coding und moderne Suchmaschinen-Sichtbarkeit.